L’Intelligenza Artificiale pensa davvero?
Potenzialità e limiti dell’IA
Che cosa chiamiamo Intelligenza Artificiale, come funzionano i sistemi che apprendono dai dati e i
Grandi Modelli Linguistici, che cosa possono fare in Medicina e quali sono i loro limiti.
Introduzione
In questo sito di divulgazione medica, un articolo che tratta di Intelligenza Artificiale potrebbe essere considerato non pertinente; in realtà è esatto il contrario: l’IA viene sempre più utilizzata anche in campo medico.
L’IA è entrata rapidamente nella nostra vita quotidiana: la utilizziamo, spesso senza rendercene conto, nei motori di ricerca web, nei telefoni cellulari, nella traduzione automatica e in molti programmi che usiamo abitualmente.
Negli ultimi anni, però, si è verificato uno sviluppo particolare: con la diffusione delle IA generative (ChatGPT, Claude, Gemini, DeepSeek, Grok ecc.) milioni di persone hanno cominciato a interagire direttamente con sistemi capaci di rispondere a domande, scrivere testi, creare immagini, riassumere documenti e sostenere conversazioni sorprendentemente naturali.
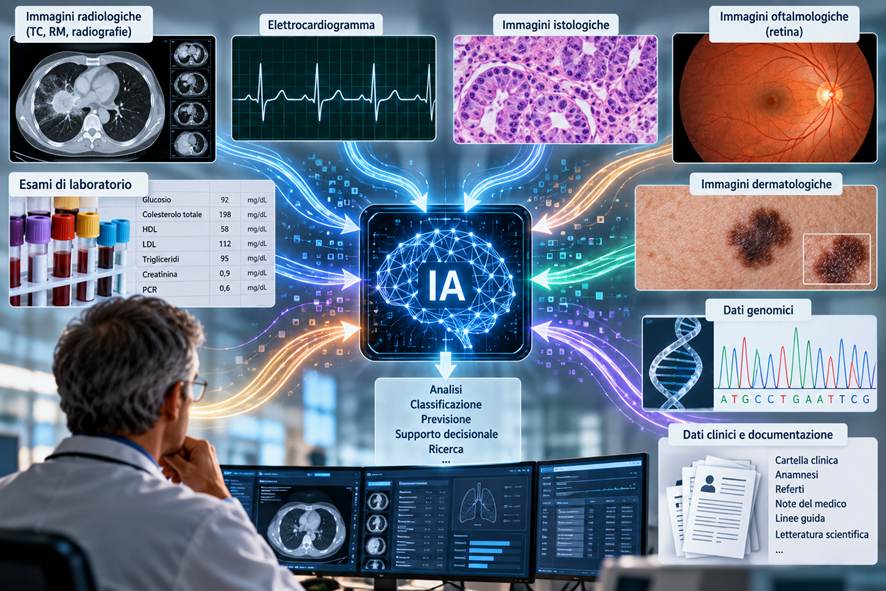
Anche in Medicina l’uso di questa tecnologia si sta diffondendo rapidamente: l’IA viene utilizzata, per esempio, per analizzare immagini diagnostiche e tracciati come l’elettrocardiogramma, valutare il rischio di alcune malattie, contribuire alla ricerca di nuovi farmaci, organizzare la documentazione clinica e fornire al medico informazioni utili per prendere decisioni [1–3].
Per questo, come webmaster di Sipal.org, mi è sembrato opportuno scrivere questa nota descrittiva dell’IA: chi visita le nostre pagine potrà trovarla utile per conoscere meglio questa tecnologia, che diventa ogni giorno più pervasiva nelle nostre attività; porto in questa trattazione la mia esperienza personale: mi occupo professionalmente di informatica da quasi cinquant’anni e, come addetto ai lavori, ho avuto modo di seguirne l’evoluzione, dai sistemi strettamente procedurali agli attuali sistemi di intelligenza artificiale.
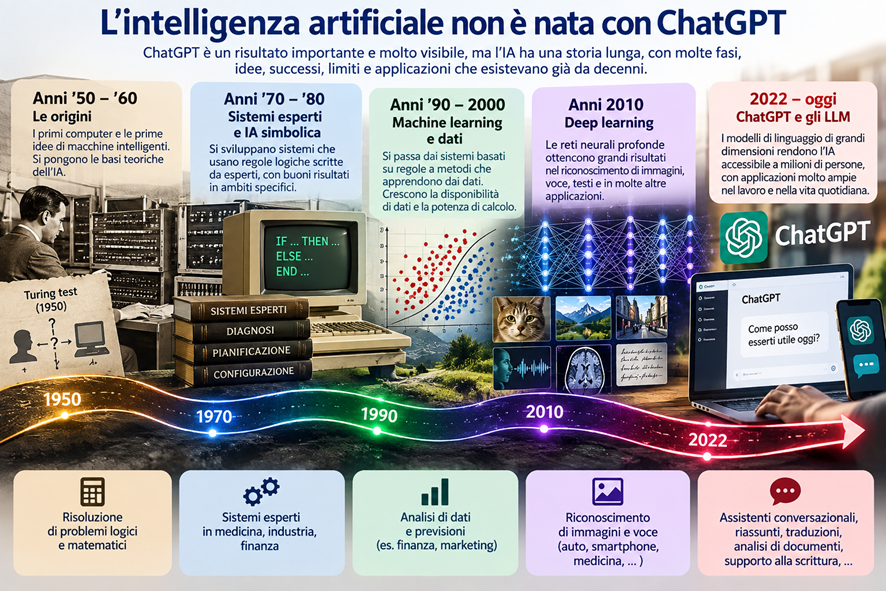
L’intelligenza artificiale non è nata con ChatGPT
ChatGPT e gli altri sistemi generativi hanno fatto conoscere l’intelligenza artificiale al grande pubblico, e l’hanno resa alla portata di tutti, ma l’IA ha una storia molto più lunga: da decenni vengono sviluppati programmi capaci di prendere decisioni, riconoscere strutture di varia complessità nei dati, adattare il proprio comportamento a seconda delle informazioni ricevute.
Io ho iniziato ad interessarmi all’IA negli anni Ottanta, utilizzando, da programmatore, i “Sistemi Esperti”, ma nello stesso periodo si dava molto spazio anche alla “logica fuzzy”, che aveva cominciato a svilupparsi a partire dagli anni Sessanta; a differenza della logica aristotelica, nella quale una condizione può essere soltanto vera o falsa, la logica fuzzy permette di rappresentare condizioni intermedie: qualcosa può essere, per esempio, poco, abbastanza o molto caldo, anziché semplicemente caldo o non caldo; questa tecnologia trovò applicazione soprattutto nei sistemi di controllo automatici e industriali, ma anche in prodotti di uso comune, come le lavatrici, e nelle componenti delle automobili [15,18].
Anche le “Reti Neurali” hanno una storia molto più lunga di quanto si potrebbe pensare: i primi modelli matematici di neurone artificiale risalgono agli anni Quaranta e Cinquanta; è stato negli anni Ottanta che queste idee conobbero un’importante fase di sviluppo, anche grazie alla diffusione di algoritmi che permettevano alle reti di modificare automaticamente i propri pesi durante l’addestramento [25].
La novità degli ultimi anni, quindi, non è la nascita dell’intelligenza artificiale: è l’enorme salto di qualità e capacità che i sistemi basati su questa tecnologia hanno compiuto.
Che cos’è l’Intelligenza Artificiale
Con il termine “Intelligenza Artificiale” si indicano sistemi informatici in grado di svolgere compiti che, se fossero eseguiti da una persona, richiederebbero “intelligenza”: riconoscere un’immagine, classificare informazioni, fare una previsione, interpretare una richiesta formulata nel linguaggio naturale, produrre un testo [1,2].
Ma bisogna fare molta attenzione: questa definizione descrive ciò che il sistema fa, non il modo in cui riesce a farlo; distinguere le due cose è essenziale per capire che cosa intendiamo realmente quando parliamo di intelligenza artificiale.
Dalla programmazione imperativa all’apprendimento automatico
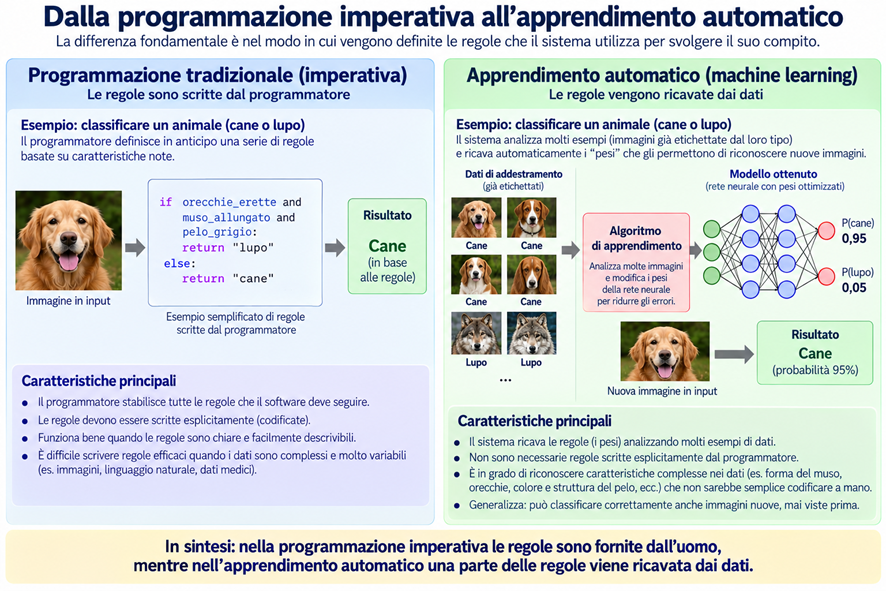
Per iniziare a capire questa tecnologia bisogna partire da una differenza sostanziale: quella tra un programma (software), nel quale siamo noi programmatori a scrivere le regole operative, e un sistema che ricava dai dati, che deve elaborare, una parte delle regole che gli servono per svolgere il suo compito.
Nella programmazione tradizionale il programmatore stabilisce in anticipo (codifica) la logica che il computer deve seguire; in forma molto semplice: SE si verifica la condizione A, ALLORA esegui la routine B.
I Sistemi Esperti, a cui ho accennato poco fa, erano un esempio di questo approccio: la conoscenza specialistica doveva essere trasformata in dati e regole utilizzabili dal programma.
Per esempio: SE il paziente presenta i sintomi A e B, ma non il sintomo C, ALLORA considera l’ipotesi diagnostica D.
Era una metodologia interessante e stimolante, ma aveva un grosso limite: quelle regole dovevano essere definite dal programmatore con la diretta collaborazione dello specialista della materia che si stava trattando, e poi essere tradotte in un linguaggio di programmazione comprensibile dalla macchina; realizzare sistemi complessi, e mantenerli aggiornati, richiedeva, quindi, un lavoro molto impegnativo e pesante.
Con il “machine learning” (apprendimento automatico), l’approccio cambia radicalmente: invece di fornire alla macchina, in anticipo, tutte le regole necessarie per eseguire il lavoro, adesso le si forniscono moltissimi esempi che, grazie a specifici algoritmi, le permettono di individuare, nei dati da elaborare, le relazioni operative per ottenere il risultato.
In altre parole, con i Sistemi Esperti cercavamo di spiegare alla macchina le regole da seguire; con il machine learning cerchiamo di farle ricavare queste regole dai dati che deve elaborare.
Tra gli strumenti che hanno contribuito maggiormente allo sviluppo del machine learning ci sono le “reti neurali artificiali” e, in particolare, il “deep learning” [1].
Che cos’è una rete neurale
Il nome può trarre in inganno: una rete neurale artificiale non è un cervello bionico e un neurone artificiale non è la riproduzione al computer di un neurone biologico.
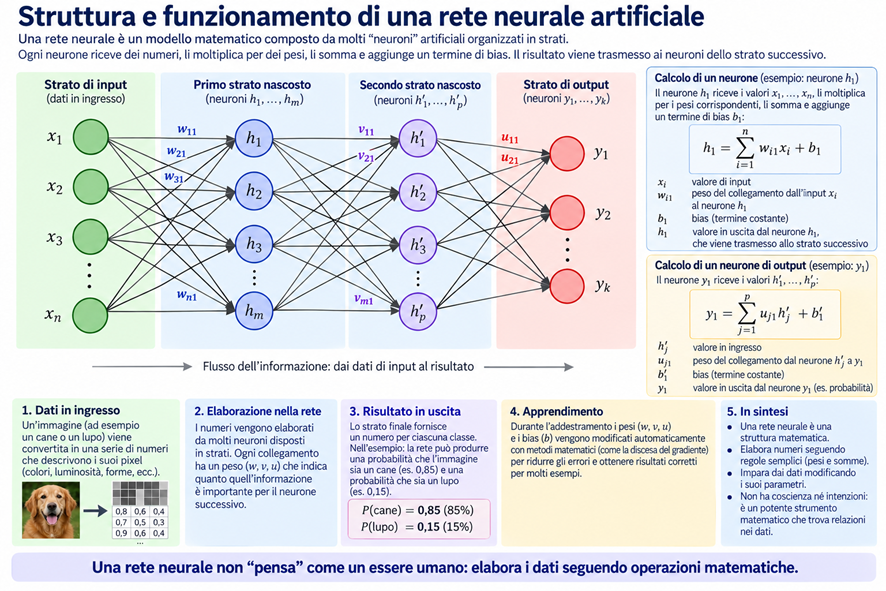
Un neurone artificiale è, molto semplicemente, una funzione matematica: riceve in input dei valori numerici, esegue su di essi dei calcoli e produce un nuovo valore.
Bisogna considerare, però, che non tutte le informazioni che il sistema riceve hanno la stessa importanza; per questo, a ciascuna viene opportunamente associato un numero, chiamato “peso”, che stabilisce quanto quell’informazione debba influire sul risultato del calcolo: un peso maggiore aumenta la sua importanza, un peso minore la riduce.
Ovviamente, una sola funzione matematica di questo tipo (neurone) può fare ben poco: una rete neurale è quindi costituita da un gran numero di queste funzioni che eseguono i loro calcoli in successione.
I neuroni vengono raggruppati, funzionalmente, in “strati”; con questo termine intendiamo non una vera e propria disposizione fisica, bensì gruppi di funzioni matematiche che operano nelle diverse fasi dell’elaborazione: i neuroni di un primo strato (fase operativa) ricevono dei valori ed eseguono i loro calcoli; i risultati ottenuti vengono passati come dati in input ai neuroni dello strato successivo che, a loro volta, eseguono nuovi calcoli.
È proprio questo passaggio dei risultati da alcune funzioni matematiche alle successive che costituisce il “collegamento” tra i neuroni; il processo continua attraverso i diversi strati fino a quello finale, che produce il risultato della rete neurale.
Quando tra i dati iniziali e il risultato finale vengono usati, per l’elaborazione, numerosi strati intermedi, si parla di rete neurale profonda, “deep neural network”, da cui deriva l’espressione “deep learning” [1].
In che senso una rete neurale “impara”?
Anche il termine “imparare” va inteso correttamente.
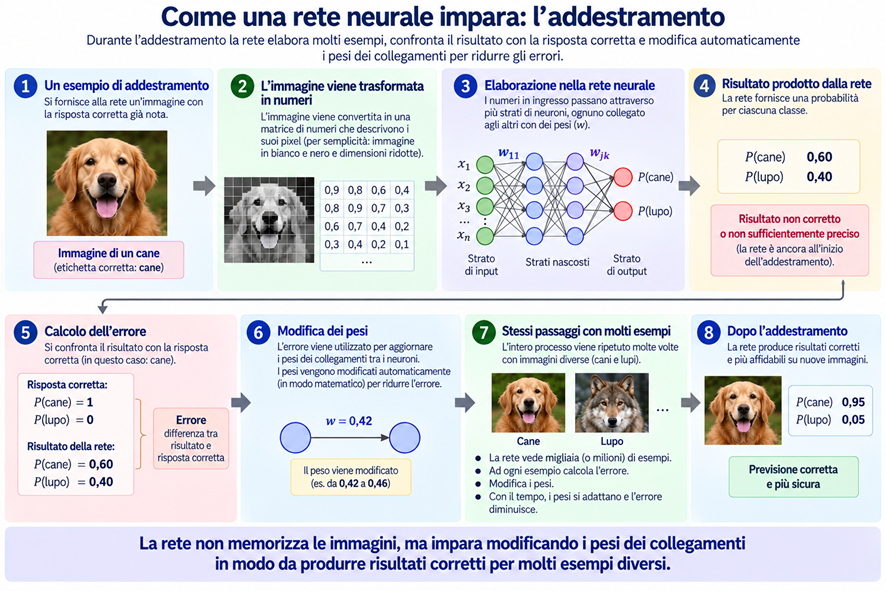
Dopo essere stata progettata e realizzata, prima che una rete neurale possa essere utilizzata, deve essere sottoposta a una fase nella quale “impara”, attraverso un gran numero di esempi, a produrre il risultato richiesto: questa fase viene definita “addestramento”.
Durante l’addestramento vengono sottoposti alla rete moltissimi esempi dei quali si conosce già il risultato corretto; per ogni esempio il sistema elabora una risposta e la confronta con quella che ci si aspetta, dopodiché un algoritmo, in base all’errore eventualmente commesso, modifica automaticamente i pesi di cui abbiamo parlato in precedenza.
Il procedimento viene ripetuto moltissime volte: modificando progressivamente i pesi, la rete diventa sempre più precisa nelle risposte e, soprattutto, utilizza sempre meglio ciò che ha appreso, anche quando riceve in input dati che non aveva mai incontrato durante l’addestramento.
È questo, in termini molto semplificati, ciò che si intende per “una rete neurale impara”: il programmatore non ha scritto, una per una, le regole necessarie per arrivare al risultato: è la rete che, attraverso l’addestramento, ha modificato progressivamente i propri parametri operativi sulla base degli esempi che le sono stati forniti.
Perché l’IA è progredita così tanto negli ultimi anni
Abbiamo visto che le idee alla base dell’intelligenza artificiale non sono così recenti; perché, allora, soltanto negli ultimi anni ci sono stati progressi così rapidi?
I motivi sono molteplici: sono cresciute contemporaneamente la potenza dei computer, l’efficacia degli algoritmi e la quantità di dati disponibili per l’apprendimento.
La maggiore potenza di calcolo ha permesso di costruire e addestrare reti neurali sempre più grandi e complesse, eseguendo in tempi brevissimi quantità di calcoli che in passato sarebbero state difficilmente affrontabili; nello stesso tempo sono profondamente migliorati gli algoritmi e le tecniche utilizzate per l’addestramento.
Ma serviva anche un’altra cosa: i dati.
L’enorme sviluppo di Internet, e la progressiva digitalizzazione delle nostre attività (diffuse in rete), hanno reso disponibili quantità enormi di testi, immagini, suoni, video e molte altre informazioni che possono essere utilizzate per addestrare questi sistemi [1,3].
È la disponibilità contemporanea di questi tre elementi “potenza di calcolo, algoritmi più efficaci e grandi quantità di dati” che ha reso possibile costruire sistemi molto più grandi, complessi ed efficienti rispetto al passato e ha determinato la straordinaria evoluzione dell’intelligenza artificiale degli ultimi anni.
L’IA in Medicina: non è più fantascienza
La pratica medica genera ogni giorno un’enorme quantità di informazioni: immagini radiologiche, campioni istologici, elettrocardiogrammi, risultati delle analisi di laboratorio, dati genomici, fotografie dermatologiche, cartelle cliniche; per questo rappresenta un campo di elezione per l’impiego di sistemi informatici potenti, in grado di analizzare grandi quantità di dati e individuarvi peculiarità che spesso l’uomo non riesce a rilevare [2].
Un paio di esempi di risultati notevoli ottenuti in campo medico:
- nel 2016 Gulshan e collaboratori pubblicarono su JAMA uno studio su un sistema di deep learning per il riconoscimento della retinopatia diabetica: la rete era stata addestrata utilizzando più di 128.000 immagini retiniche [4].
- Nel 2017 Esteva e collaboratori descrissero su Nature una rete neurale addestrata su 129.450 immagini di lesioni cutanee; in alcuni aspetti del lavoro di classificazione, questo sistema raggiunse prestazioni confrontabili con quelle dei dermatologi partecipanti allo studio [5].
Sono esempi importanti, perché mostrano che una macchina può raggiungere prestazioni molto elevate in attività mediche specifiche.
Ma anche qui bisogna fare molta attenzione: un sistema che raggiunge prestazioni paragonabili, o addirittura superiori, a quelle di un medico, in uno specifico compito, non è per questo diventato un medico: ha soltanto svolto molto bene quel lavoro.
Gli LLM (Large Language Models)
Fin qui abbiamo parlato di sistemi che classificano o prevedono.
Con i “Large Language Models” (LLM), i grandi modelli linguistici, sui quali sono basati i sistemi come ChatGPT, entriamo invece nel campo dell’elaborazione e della generazione del linguaggio.
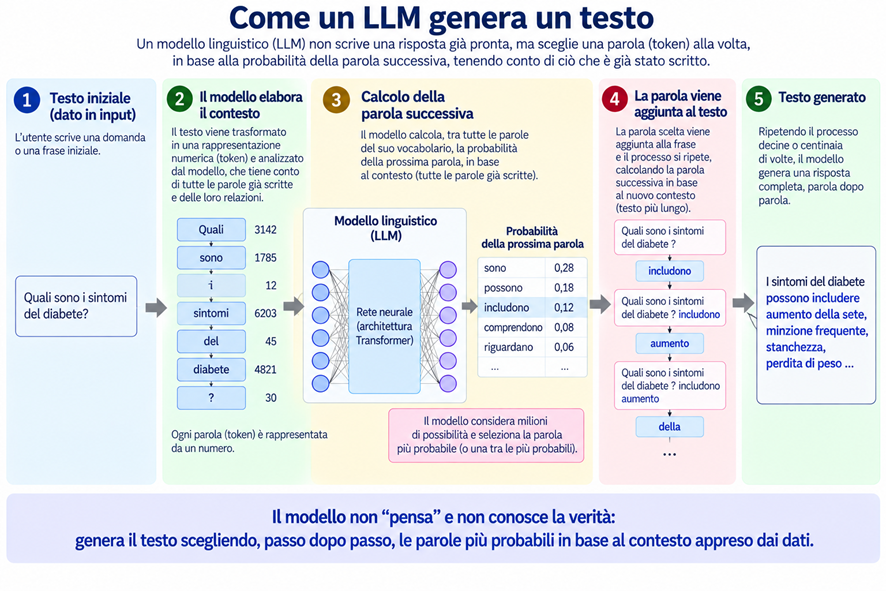
Durante l’addestramento, un LLM analizza enormi quantità di testo, che viene trattato come una sequenza di elementi, chiamati “token”.
I token possono essere costituiti da una parola intera, da una parte di parola, da un numero, da un segno di punteggiatura, da un simbolo [9,14].
Uno dei meccanismi fondamentali dell’addestramento di queste specifiche reti neurali consiste nell’imparare a prevedere quale token possa seguire quelli che lo precedono.
Per sottolineare la natura statistica di questo processo, nel 2021 Emily Bender (docente di Linguistica Computazionale all’Università di Washington) e altri ricercatori utilizzarono l’espressione “pappagalli stocastici” [14].
Stocastico significa, in ambiente matematico-informatico, che il sistema opera sulla base di probabilità; il riferimento al pappagallo vuole sottolineare che può produrre testi in un linguaggio sorprendentemente simile a quello umano, senza che ciò implichi, da parte sua, una comprensione del loro significato paragonabile a quella umana.
L’espressione è suggestiva (e divertente!), ma, a mio parere, può essere anche riduttiva: potrebbe infatti far pensare che un LLM cerchi nei testi utilizzati per l’addestramento frasi già esistenti, per poi combinarle e riproporle.
Ma non è questo ciò che avviene!
Durante l’addestramento il sistema analizza un’enorme quantità di testi e, attraverso questo processo, modifica progressivamente i pesi di cui abbiamo parlato in precedenza; in questo modo la rete apprende le relazioni presenti nei testi e acquisisce la capacità di utilizzarle anche di fronte a richieste nuove.
Non mantiene, quindi, una raccolta di frasi da recuperare e riutilizzare: ciò che ha appreso è rappresentato dalle modifiche apportate ai suoi pesi durante l’addestramento.
E allora, quando successivamente genera una risposta, non cerca semplicemente una frase già scritta da qualcuno per copiarla o combinarla con altre: costruisce il testo progressivamente, token dopo token, sulla base delle relazioni apprese durante l’addestramento e delle informazioni presenti nella conversazione.
È proprio questo che gli permette, per esempio, non soltanto di completare una frase, ma anche di riassumere un testo che gli abbiamo appena fornito, spiegarne il contenuto con parole diverse, confrontarlo con un altro testo, rispondere a una nostra obiezione o modificare una spiegazione quando gli diciamo che non è chiara.
Perché gli LLM sono così utili
La caratteristica che ha reso gli LLM immediatamente accessibili a milioni di persone è evidente: possiamo comunicare con loro usando il nostro linguaggio umano.
Non è necessario conoscere SQL, un linguaggio di programmazione o una particolare sintassi: possiamo formulare una domanda, sottoporre un problema, chiedere un aiuto tecnico o replicare a una risposta proprio come faremmo conversando con una persona.
Un LLM può così riassumere o riformulare un documento, tradurre un testo, spiegare lo stesso concetto in differenti modi, confrontare informazioni, aiutare nella scrittura e tenere conto di ciò che è stato detto in precedenza nella conversazione.
Un LLM non è un database
Avendo lavorato per molti anni con le basi di dati, mi sembra utile sottolineare una differenza fondamentale tra interrogare un database e porre una domanda a un LLM.
In un database i dati sono memorizzati in modo strutturato; se, per esempio, chiedo la data di nascita di una persona, il programma cerca il valore registrato nel campo corrispondente: se lo trova, lo restituisce, se non lo trova, segnala che quel dato non è presente.
Quando pongo la stessa domanda a un LLM avviene qualcosa di profondamente diverso: il sistema non consulta necessariamente un archivio nel quale può essere registrata quella data, ma genera una risposta sulla base di ciò che ha appreso durante l’addestramento e delle informazioni che ha a disposizione in quel momento.
La differenza è importante: il database recupera un dato che è stato memorizzato, un LLM, invece, genera una risposta, e può produrla anche quando non dispone di informazioni sufficienti per “fornirla correttamente” (ne parleremo in dettaglio più avanti!).
Oltre alle informazioni apprese durante l’addestramento, un LLM può anche utilizzare informazioni provenienti da fonti esterne, come banche dati, raccolte di documenti o motori di ricerca; in questo caso le informazioni presenti nelle fonti esterne vengono fornite all’LLM come ulteriore materiale da utilizzare per generare la risposta.
Quanto possiamo fidarci dell’IA?
Le possibilità dell’intelligenza artificiale, quindi, sono notevoli, ma per utilizzarla correttamente bisogna capire anche in quali modi può produrre risultati sbagliati.
Non tutti gli errori hanno la stessa origine: un LLM può generare una risposta inattendibile, un sistema può aver imparato dai dati una relazione sbagliata o una distorsione concettuale, oppure può essere utilizzato intenzionalmente da una persona per costruire informazioni fraudolente.
Quando l’LLM inventa la risposta: le “hallucination”
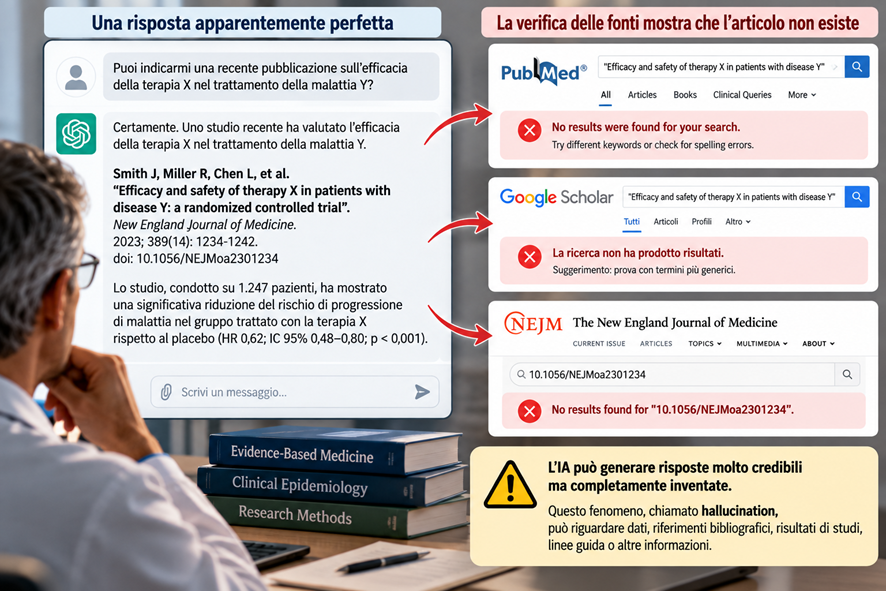
Un LLM può produrre informazioni inesatte o completamente inventate, formulate però in modo perfettamente plausibile: è il fenomeno conosciuto come “hallucination” (allucinazione) [8,9].
Il problema è particolarmente insidioso, perché un sistema generativo, come ChatGPT, riesce a formulare una risposta precisa, ben strutturata e convincente anche quando contiene informazioni sbagliate, e spesso non c’è nulla, nella forma della risposta, che permetta all’utente di accorgersi dell’errore.
Può persino inventare il titolo di un articolo scientifico, gli autori, il nome della rivista e un riferimento bibliografico che sembra autentico [8,9].
Quando l’IA impara la cosa sbagliata
Un altro tipo di errore ha un’origine diversa: non nasce nel momento in cui il sistema produce la risposta, ma da ciò che ha imparato durante l’addestramento.
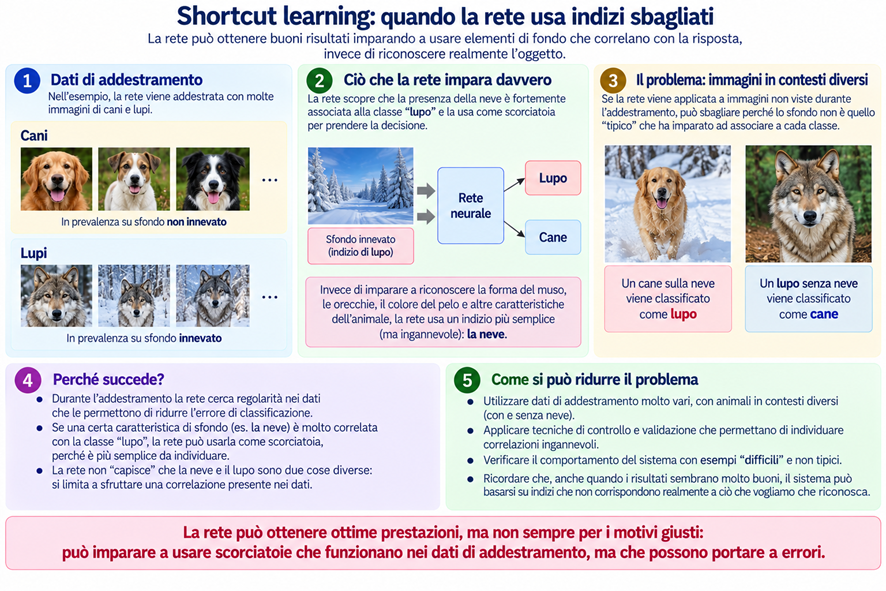
Immaginiamo di addestrare un sistema a distinguere, in fotografia, un cane da un lupo.
Se, nelle foto utilizzate per l’addestramento, i lupi fossero fotografati quasi sempre sulla neve e i cani quasi sempre in altri ambienti, il sistema potrebbe trovare una scorciatoia: utilizzare la presenza della neve come indizio per riconoscere il lupo, invece di basarsi sulle caratteristiche dei due animali.
Perciò, se nel lavoro quotidiano deve trattare immagini simili a quelle utilizzate per addestrarlo, darebbe risposte impeccabili; ma, davanti alla fotografia di un cane sulla neve, rischierebbe di confonderlo con un lupo!
Il sistema può, quindi, classificare correttamente molte immagini, ma per la ragione sbagliata: nell’esempio precedente, potrebbe riconoscere il lupo soprattutto dalla presenza della neve, anziché dalle caratteristiche proprie dell’animale.
Questo fenomeno è noto come “shortcut learning” [16].
Un problema simile può verificarsi in Medicina ed avere conseguenze molto più serie: un sistema addestrato a riconoscere una malattia nelle immagini diagnostiche potrebbe imparare a utilizzare, insieme ai veri segni della malattia, anche alcune caratteristiche legate all’apparecchiatura utilizzata o all’ospedale da cui provengono le immagini; otterrebbe, quindi, ottimi risultati in condizioni di lavoro simili a quelle dell’addestramento, ma sarebbe meno affidabile se utilizzato con apparecchiature diverse o in altri ospedali.
Quando il problema è nei dati che forniamo
Il sistema può apprendere correttamente ciò che trova nei dati, ma essere comunque portato a generare conclusioni distorte: questo accade quando i dati stessi rappresentano male la realtà.
Un esempio eclatante riguarda un sistema sperimentale sviluppato da Amazon per la selezione del personale: era stato addestrato prevalentemente sui curricula ricevuti dall’azienda negli anni precedenti, in gran parte provenienti da uomini, e questa distorsione lo portò a penalizzare alcuni elementi associati alle candidate donne. Nessuno aveva programmato una regola del tipo “preferisci gli uomini alle donne”: la distorsione emergeva dai dati utilizzati per l’addestramento e, di conseguenza, il progetto dovette essere abbandonato [17].
Questo problema è particolarmente importante quando si impiegano reti neurali in medicina.
Nei dati utilizzati per l’addestramento possono essere presenti degli squilibri: alcuni gruppi di pazienti, con particolari caratteristiche, possono essere poco rappresentati; i dati possono provenire prevalentemente da determinate aree geografiche, strutture sanitarie o fasce di popolazione; possono, inoltre, essere viziati da differenze esistenti nell’accesso alle cure, nelle diagnosi e nei trattamenti ricevuti dai diversi gruppi di pazienti.
Per questo non basta sapere quanti dati siano stati utilizzati: bisogna anche verificare da quali pazienti provengano e se rappresentino adeguatamente tutte le persone sulle quali il sistema verrà utilizzato.
L’intelligenza artificiale non conosce la realtà: impara dalla rappresentazione della realtà contenuta nei dati che le vengono forniti nell’addestramento; se quella rappresentazione è incompleta o distorta, anche ciò che il sistema impara sarà incompleto o distorto.
Nell’addestramento, la quantità dei dati forniti è importante, ma la loro qualità e la loro rappresentatività lo sono forse di più.
Quando l’IA viene utilizzata per costruire intenzionalmente il falso
C’è infine un problema analogo ma di natura profondamente diversa: l’IA può essere utilizzata deliberatamente per costruire informazioni fraudolente.
Anche un articolo pubblicato il 14 settembre 2026 sul Corriere della Sera (edizione web) ha richiamato l’attenzione su diversi possibili usi impropri dell’IA nella produzione scientifica, tra cui testi e immagini manipolati, riferimenti bibliografici inesistenti e dati artificiali presentati come reali [23].
La possibilità di utilizzare un LLM per fabbricare, intenzionalmente, dati medici fittizi è stata documentata direttamente anche nella letteratura scientifica: in una Research Letter pubblicata nel 2023 su JAMA Ophthalmology, Taloni, Scorcia e Giannaccare mostrarono che GPT-4 con Advanced Data Analysis poteva generare un dataset fittizio costruito per soddisfare criteri statistici stabiliti in anticipo [24].
Gli autori sottolinearono il rischio che strumenti di questo tipo possano essere utilizzati impropriamente per fabbricare dati di ricerca artefatti, e richiamarono la necessità di rafforzare i controlli sull’autenticità dei dati [24].
È importante distinguere questo caso dall’allucinazione: nell’allucinazione l’LLM genera autonomamente una risposta falsa presentandola come verosimile; nella frode, invece, è una persona che utilizza deliberatamente la capacità generativa del sistema per costruire un falso da far passare per vero.
Perché può essere difficile accorgersi dell’errore
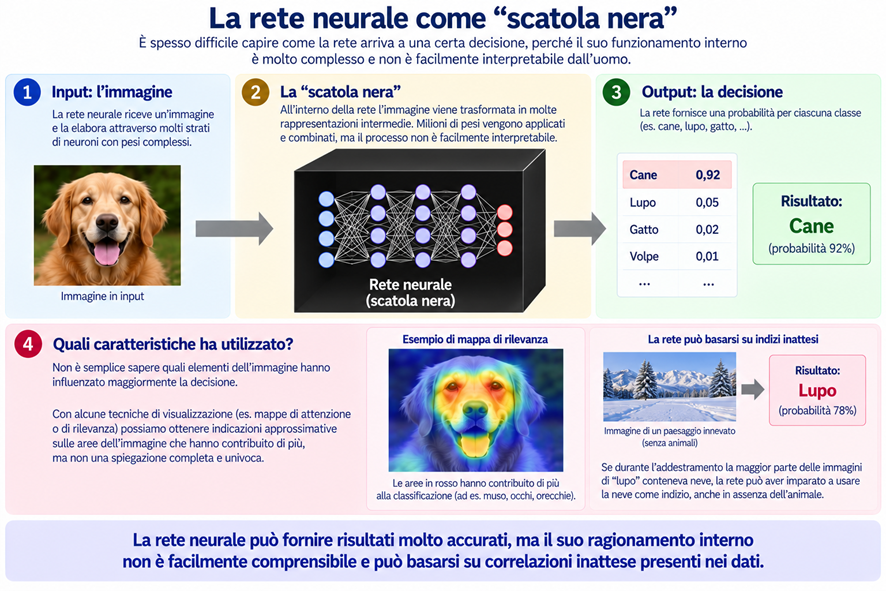
A rendere ulteriormente delicato il problema c’è il fatto che non è facile capire perché una grande rete neurale sia arrivata a una determinata conclusione.
In un programma tradizionale possiamo esaminare il codice (le regole scritte dal programmatore) e ricostruire il percorso che ha portato al risultato; in una grande rete neurale, invece, ciò che il sistema ha appreso è distribuito tra un numero enorme di parametri e nelle loro relative interazioni: è quello che viene definito “il problema della black box”, la “scatola nera”.
Questo problema diventa particolarmente importante e delicato quando il sistema ha imparato qualcosa di sbagliato: in questo caso può essere difficile capire quali informazioni abbia realmente utilizzato per arrivare alla sua risposta.
Nel 2025 il consorzio internazionale FUTURE-AI ha pubblicato delle linee guida per un’intelligenza artificiale affidabile e utilizzabile nella pratica sanitaria, basate su sei principi: “fairness, universality, traceability, usability, robustness ed explainability” (equità, universalità, tracciabilità, usabilità, robustezza e spiegabilità) [7].
Non basta quindi che un algoritmo “funzioni”: è necessario sapere quanto funziona, su quali pazienti, in quali condizioni e con quali possibilità di errore.
Come ridurre il rischio
I problemi che abbiamo descritto hanno origini diverse e non possono essere prevenuti tutti nello stesso modo; è necessario controllare la qualità dei dati utilizzati per l’addestramento, verificare che siano congruenti al compito da svolgere e testare il comportamento del sistema anche in condizioni diverse da quelle nelle quali è stato sviluppato.
Nel caso degli LLM, una delle tecniche utilizzate per ridurre il rischio di risposte non fondate, o addirittura inventate, consiste nel ricorrere a fonti esterne verificate, come detto in precedenza: questa tecnica prende il nome di “Retrieval-Augmented Generation” (RAG) [13].
In campo medico è particolarmente importante che le fonti utilizzate siano affidabili e aggiornate.
La RAG può ridurre il rischio che l’LLM produca informazioni prive di fondamento, ma non garantisce che la risposta sia sempre corretta.
Il livello di controllo da applicare è anche in funzione dell’uso che facciamo dell’intelligenza artificiale: se chiediamo a un LLM di migliorare lo stile di una lettera, un eventuale errore sarà generalmente facile da riconoscere e avrà conseguenze modeste; se invece gli chiediamo informazioni dalle quali possono dipendere decisioni importanti, la verifica deve essere molto più rigorosa.
Quanto più un errore può avere conseguenze importanti, tanto più accuratamente deve essere verificata la risposta.
L’IA capisce davvero quello che dice?
A questo punto possiamo affrontare una delle domande (o, forse, “la domanda”) che rendono così affascinanti gli attuali sistemi generativi: l’IA pensa?
Interagendo con un chatbot possiamo avere l’impressione che, dall’altra parte dello schermo, ci sia qualcuno che segue il nostro ragionamento: il sistema utilizza le informazioni fornite nei messaggi precedenti, risponde alle nostre obiezioni e può modificare una spiegazione quando gli diciamo che non è chiara.
Di fronte a comportamenti di questo genere ci viene naturale dire che il sistema “capisce”, “pensa”, “sa”, “decide”: sono le stesse parole che utilizziamo quando parliamo di una persona.
Ma parole come “capire” o “pensare” assumono un significato diverso quando le riferiamo a una persona o a un sistema di intelligenza artificiale: quando diciamo che una persona “comprende”, intendiamo che ciò di cui parla ha per lei un significato legato alla sua conoscenza del mondo e alla sua esperienza.
Un sistema di intelligenza artificiale, invece, può produrre risposte appropriate e svolgere compiti anche molto complessi, ma questo non significa che abbia una comprensione paragonabile alla nostra.
La differenza fra ciò che un sistema IA sa produrre e ciò che può dare l’impressione di “provare” diventa particolarmente evidente quando parliamo di emozioni.
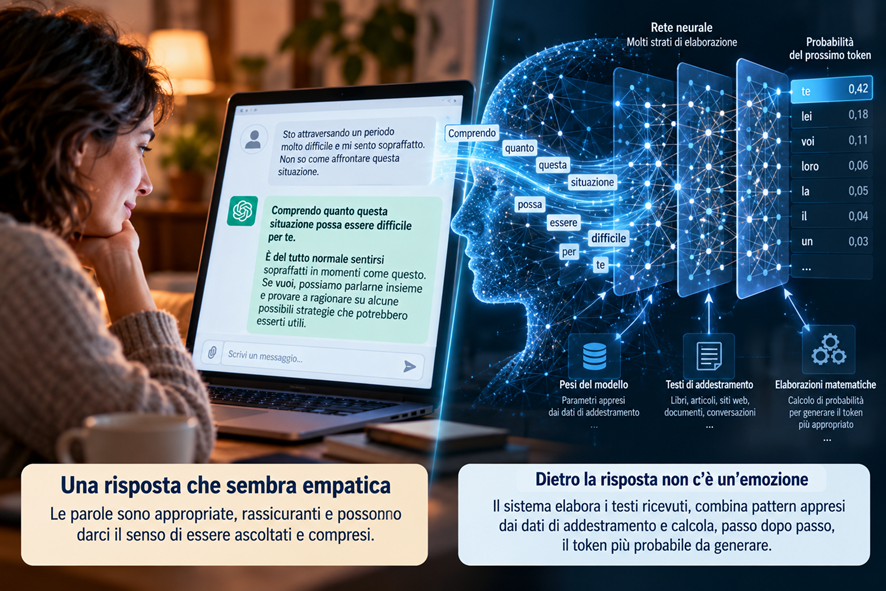
Un chatbot può dire a un utente: «Comprendo quanto questa situazione possa essere difficile per te». La frase può essere appropriata, empatica e perfino rassicurante, ma questo non significa che il sistema provi realmente preoccupazione o compassione.
Uno studio pubblicato nel 2023 su JAMA Internal Medicine aiuta a comprendere bene questa distinzione [6]. I ricercatori confrontarono le risposte date da alcuni medici a 195 domande pubblicate nella comunità r/AskDocs di Reddit (una piattaforma online organizzata in comunità di discussione tematica) con le risposte generate da ChatGPT.
Nelle 585 valutazioni effettuate, i valutatori preferirono la risposta del chatbot nel 78,6% dei casi, giudicandola, in quello specifico contesto, migliore per qualità ed empatia rispetto alla risposta data dai medici.
Il dato è estremamente interessante e indicativo: mostra che una macchina può produrre una risposta che un essere umano percepisce come empatica, non che la macchina effettivamente provi empatia.
E la creatività?
La questione della creatività è, forse, più complessa.
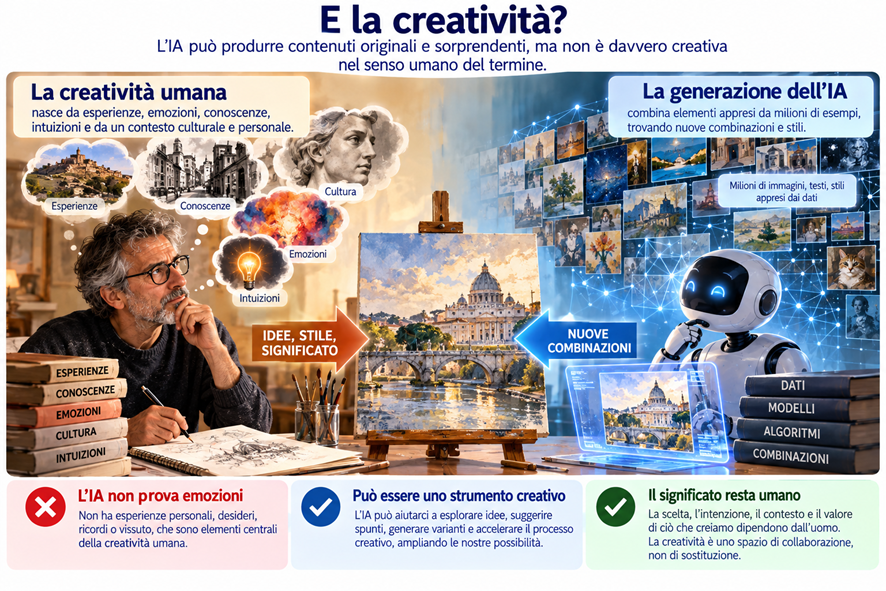
I sistemi generativi possono produrre immagini che prima non esistevano, scrivere racconti e poesie, comporre musica, inventare metafore e proporre soluzioni che non sono state fornite durante la fase di addestramento: dire semplicemente che l’IA “copia” sarebbe quindi riduttivo.
Ma anche in questo caso dobbiamo chiarire che cosa intendiamo per creatività.
Se consideriamo frutto della creatività qualcosa di nuovo, originale e interessante, allora anche ciò che viene prodotto dall’IA può soddisfare questi criteri.
Se invece con creatività intendiamo un processo di produzione intellettiva legato a intenzioni, esperienze personali, emozioni, desideri e motivazioni, allora la questione cambia.
Un sistema artificiale può scrivere una poesia che parli della morte senza avere coscienza che morirà; può descrivere un innamoramento senza averlo mai provato; può raccontare la nostalgia senza avere ricordi personali.
Il risultato può essere bello e suggestivo, ma il processo che lo ha prodotto non è l’esperienza creativa di una persona!
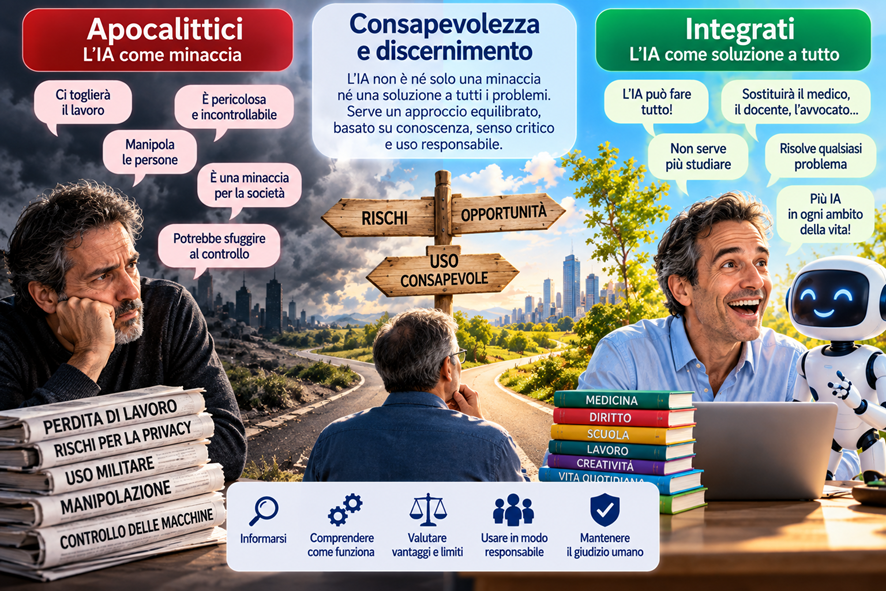
Tra “apocalittici” e “integrati”
Ho letto alcuni mesi fa “L’inganno dell’intelligenza artificiale”, della linguista computazionale Emily M. Bender e della sociologa Alex Hanna: le autrici hanno una posizione fortemente critica nei confronti dell’IA e mettono in guardia contro l’entusiasmo che spesso ne accompagna lo sviluppo e la diffusione, il cosiddetto “hype” [12].
Anche se non condivido completamente la posizione di Bender e Hanna, considero molto importante il loro invito a guardare con spirito critico ciò che l’intelligenza artificiale è realmente in grado di fare, senza lasciarsi condizionare dall’impressione prodotta dai suoi risultati.
Questa contrapposizione tra entusiasmo e diffidenza nei confronti di una nuova tecnologia mi ha fatto tornare in mente “Apocalittici e integrati”, saggio pubblicato da Umberto Eco nel 1964.
Ovviamente Eco non parlava di intelligenza artificiale (non era ancora tempo!), ma analizzava due atteggiamenti opposti di fronte alla cultura di massa e ai nuovi mezzi di comunicazione: da una parte chi ne vedeva soprattutto i pericoli, dall’altra chi tendeva ad accoglierli con entusiasmo [20].
A distanza di oltre sessant’anni, quella contrapposizione si adatta senz’altro anche al dibattito sull’intelligenza artificiale: anche oggi troviamo chi la considera soprattutto una minaccia e chi, al contrario, è entusiastico utilizzatore delle sue capacità, che considera quasi illimitate.
Credo che l’atteggiamento più ragionevole sia evitare entrambe le posizioni: conoscere i limiti dell’IA non significa negarne le possibilità, così come riconoscerne le capacità non significa attribuirle qualità che non possiede.
La posizione della WHO: utilizzare l’IA, ma con precise regole
L’Organizzazione Mondiale della Sanità (WHO) riconosce le potenzialità dell’intelligenza artificiale nella diagnosi, nel trattamento medico, nella ricerca, nello sviluppo dei farmaci e nell’organizzazione del servizio sanitario, ma insiste sulla necessità di governarne l’uso [10].
Nelle linee guida del 2021 individua sei principi fondamentali: tutela dell’autonomia umana; promozione del benessere, della sicurezza e dell’interesse pubblico; trasparenza, spiegabilità e intelligibilità; responsabilità; inclusività ed equità; sostenibilità e capacità di risposta [10].
Con la diffusione dell’IA generativa il problema si è ampliato: la WHO ha elaborato una guida specifica ai Large Multi-Modal Models, sistemi capaci di ricevere e produrre informazioni di tipo diverso, come testi e immagini [11].
Tra i problemi affrontati ci sono l’accuratezza delle informazioni, le distorsioni (bias), la tutela dei dati, la sicurezza e il rischio di affidarsi eccessivamente alle indicazioni generate dai sistemi IA.
Il messaggio di fondo è semplice: l’IA può essere utile alla medicina, ma deve essere sviluppata e utilizzata mettendo al centro sicurezza, diritti dei pazienti e responsabilità degli operatori sanitari.
Il quadro normativo europeo e quello italiano
Anche il legislatore ha iniziato a tradurre questi principi in normativa: nell’Unione Europea l’”AI Act” prevede, per i sistemi classificati ad alto rischio, requisiti particolarmente rigorosi in materia di gestione dei rischi, qualità dei dati, tracciabilità, sorveglianza umana, accuratezza e sicurezza [21].
Per l’utente italiano è molto importante la legge n. 132 del 2025, che prescrive specifiche regole per l’impiego dell’intelligenza artificiale in sanità: la norma stabilisce che il paziente debba essere informato quando vengono utilizzate tecnologie di IA e che i sistemi e i dati impiegati debbano essere affidabili, periodicamente verificati e aggiornati per ridurre il rischio di errori [22].
Soprattutto, stabilisce un principio molto chiaro: l’intelligenza artificiale può costituire un valido aiuto nella prevenzione, nella diagnosi, nella cura e nella scelta terapeutica, ma la decisione rimane, sempre e comunque, affidata al medico [22].
La FDA: l’intelligenza artificiale è già nei dispositivi medici
Che l’intelligenza artificiale in medicina non sia più soltanto una prospettiva futura lo dimostra anche l’attività della Food and Drug Administration (FDA) americana.
La FDA redige e mantiene un elenco di dispositivi medici che incorporano tecnologie di intelligenza artificiale e che sono stati autorizzati alla commercializzazione negli Stati Uniti; si tratta di sistemi destinati a impieghi specifici in diversi settori della medicina, molti dei quali riguardano l’analisi e l’interpretazione di immagini diagnostiche [19].
È importante capire bene che cosa significa questa autorizzazione: la FDA precisa che i dispositivi presenti nell’elenco hanno seguito i percorsi regolatori previsti e soddisfatto i requisiti richiesti per la loro commercializzazione, che comprendono la valutazione della sicurezza e dell’efficacia rispetto all’impiego per il quale sono stati proposti [19].
L’autorizzazione, quindi, non riguarda genericamente “l’intelligenza artificiale”, bensì uno specifico dispositivo destinato a uno specifico impiego; non significa che qualsiasi applicazione dell’IA in medicina sia sicura, né che possa essere utilizzata al di fuori delle condizioni per le quali è stata valutata o senza un adeguato controllo professionale.
Questo aspetto è particolarmente importante perché aiuta a distinguere due realtà che nel dibattito sull’intelligenza artificiale vengono talvolta confuse: da una parte ci sono i sistemi generativi di uso generale, come ChatGPT; dall’altra, esistono dispositivi medici che utilizzano tecnologie di IA per svolgere compiti ben definiti e che, prima di essere immessi sul mercato, sono sottoposti a uno specifico percorso regolatorio.
L’esistenza di questi dispositivi dimostra quindi qualcosa di molto concreto: l’intelligenza artificiale è già passata, in numerose applicazioni mediche, dalla ricerca alla pratica clinica regolamentata.
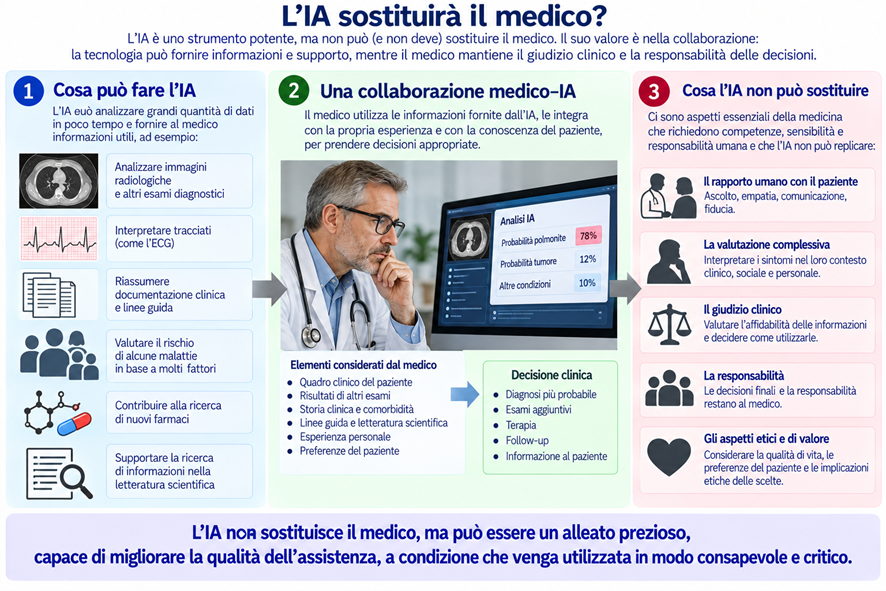
L’IA sostituirà il medico?
È una domanda che viene posta sempre più spesso e con sempre maggiore inquietudine, ma è una domanda non appropriata.
Un computer può elaborare in pochi secondi quantità di dati che nessun essere umano potrebbe trattare nello stesso tempo; può confrontare migliaia di immagini, individuare associazioni tra dati difficilmente percepibili dall’uomo e ripetere lo stesso calcolo milioni di volte senza stancarsi: sono capacità reali e bisogna apprezzarle.
Ma il medico non riceve in ambulatorio un insieme di variabili: riceve una persona.
Deve raccoglierne la storia, valutare informazioni incomplete o contraddittorie, interpretare sintomi che non sempre sono chiaramente classificabili, considerare altre malattie concomitanti (comorbidità), terapie, condizioni familiari e sociali, stili di vita e paure; e alla fine deve assumersi la responsabilità di una decisione.
Questa differenza è fondamentale e deve sempre essere tenuta presente da chi utilizza direttamente sistemi come ChatGPT: un LLM può essere utile per comprendere meglio un termine medico, un referto o un argomento sanitario, ma non deve essere utilizzato per formulare autonomamente una diagnosi su sé stessi né per decidere di iniziare, modificare o sospendere una terapia.
Questo non significa contrapporre il medico all’intelligenza artificiale: nel 2019 Eric Topol parlava di “high-performance medicine”, che deriva dalla collaborazione tra intelligenza umana e artificiale [3].
È sicuramente questo l’atteggiamento più appropriato: non chiedere alla macchina di diventare un medico, né chiedere al medico di competere con una macchina nella velocità di elaborazione delle informazioni; ciascuno va impiegato per ciò che sa fare meglio.
Conclusioni (e una riflessione personale)
Dopo tanti anni di lavoro nell’informatica, gli attuali sistemi di intelligenza artificiale mi sembrano, allo stesso tempo, familiari e sorprendenti.
Familiari, perché dietro l’apparente naturalezza della conversazione con i chatbot, ci sono sempre matematica, algoritmi e dati.
Sorprendenti, perché oggi questi sistemi riescono a svolgere compiti che era difficile immaginare alcuni decenni fa, quando lavoravamo con attrezzature che oggi farebbero sorridere.
È proprio questo contrasto che trovo particolarmente interessante: strumenti, costruiti su principi che conosco da sempre, sono arrivati a produrre risultati che un tempo non avrei neanche immaginato.
Riconoscerne le notevoli capacità, tuttavia, non significa attribuire loro un modo di pensare simile al nostro.
E a questo punto credo sia appropriato tirare una linea conclusiva: un sistema di intelligenza artificiale può analizzare una poesia, spiegarla, imitarne lo stile e persino generare versi capaci di emozionarci; ma non prova l’emozione che quei versi descrivono.
Può scrivere parole che esprimono lo stupore di fronte all’immensità e alla bellezza del creato, ma soltanto un essere umano può, come Ungaretti, vivere quell’emozione ed esprimerla mirabilmente dicendo:
«M’illumino d’immenso».
Corrado Ferracci
già Funzionario Tecnico e Responsabile Sviluppo Software
Dipartimento di Scienze Cliniche e Medicina Traslazionale
Università degli Studi di Roma “Tor Vergata”
Nota sulle immagini: tutte le immagini e le infografiche presenti nell’articolo sono state generate mediante sistemi di intelligenza artificiale, sulla base di mie indicazioni e dei contenuti sviluppati nel testo.
Bibliografia
1. LeCun Y, Bengio Y, Hinton G. “Deep learning”. Nature. 2015;521:436–444. doi:10.1038/nature14539.
2. Rajpurkar P, Chen E, Banerjee O, Topol EJ. “AI in health and medicine”. Nat Med. 2022;28:31–38. doi:10.1038/s41591-021-01614-0.
3. Topol EJ. “High-performance medicine: the convergence of human and artificial intelligence”. Nat Med. 2019;25:44–56. doi:10.1038/s41591-018-0300-7.
4. Gulshan V, Peng L, Coram M, et al. “Development and Validation of a Deep Learning Algorithm for Detection of Diabetic Retinopathy in Retinal Fundus Photographs”. JAMA. 2016;316(22):2402–2410. doi:10.1001/jama.2016.17216.
5. Esteva A, Kuprel B, Novoa RA, et al. “Dermatologist-level classification of skin cancer with deep neural networks”. Nature. 2017;542:115–118. doi:10.1038/nature21056.
6. Ayers JW, Poliak A, Dredze M, et al. “Comparing Physician and Artificial Intelligence Chatbot Responses to Patient Questions Posted to a Public Social Media Forum”. JAMA Intern Med. 2023;183(6):589–596. doi:10.1001/jamainternmed.2023.1838.
7. Lekadir K, Frangi AF, Porras AR, et al. “FUTURE-AI: international consensus guideline for trustworthy and deployable artificial intelligence in healthcare”. BMJ. 2025;388:e081554. doi:10.1136/bmj-2024-081554.
8. Ji Z, Lee N, Frieske R, et al. “Survey of Hallucination in Natural Language Generation”. ACM Comput Surv. 2023;55(12):Article 248, 1–38. doi:10.1145/3571730.
9. Omiye JA, Gui H, Rezaei SJ, Zou J, Daneshjou R. “Large Language Models in Medicine: The Potentials and Pitfalls: A Narrative Review”. Ann Intern Med. 2024;177(2):210–220. doi:10.7326/M23-2772.
10. World Health Organization. “Ethics and governance of artificial intelligence for health: WHO guidance”. Geneva: World Health Organization; 2021. ISBN 978-92-4-002920-0.
11. World Health Organization. “Ethics and governance of artificial intelligence for health: guidance on large multi-modal models”. Geneva: World Health Organization; 2024. ISBN 978-92-4-008475-9.
12. Bender EM, Hanna A. “The AI Con: How to Fight Big Tech’s Hype and Create the Future We Want”. New York: HarperCollins; 2025. Edizione italiana: “L’inganno dell’intelligenza artificiale. Come resistere a Big Tech e costruire il futuro che vogliamo”. Trad. Roberto Laghi. Roma: Fazi Editore; 2026.
13. Lewis P, Perez E, Piktus A, et al. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”. Adv Neural Inf Process Syst. 2020;33:9459–9474.
14. Bender EM, Gebru T, McMillan-Major A, Shmitchell S. “On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?” In: Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency (FAccT ’21). 2021:610–623. doi:10.1145/3442188.3445922.
15. Zadeh LA. “Fuzzy sets”. Information and Control. 1965;8(3):338–353. doi:10.1016/S0019-9958(65)90241-X.
16. Geirhos R, Jacobsen JH, Michaelis C, et al. “Shortcut learning in deep neural networks”. Nat Mach Intell. 2020;2:665–673. doi:10.1038/s42256-020-00257-z.
17. Dastin J. “Amazon scraps secret AI recruiting tool that showed bias against women”. Reuters. 10 ottobre 2018.
18. Perry TS. “Lotfi Zadeh and the Birth of Fuzzy Logic”. IEEE Spectrum. Giugno 1995; versione online successivamente aggiornata.
19. U.S. Food and Drug Administration. “Artificial Intelligence-Enabled Medical Devices”. Elenco istituzionale aggiornato periodicamente.
20. Eco U. “Apocalittici e integrati”. Milano: Bompiani; 1964.
21. Regolamento (UE) 2024/1689 del Parlamento europeo e del Consiglio, del 13 giugno 2024, che stabilisce regole armonizzate sull’intelligenza artificiale (Artificial Intelligence Act). Gazzetta ufficiale dell’Unione europea, 12 luglio 2024.
22. Legge 23 settembre 2025, n. 132. Disposizioni e deleghe al Governo in materia di intelligenza artificiale. Gazzetta Ufficiale della Repubblica Italiana, Serie generale n. 223, 25 settembre 2025.
23. Gabanelli M, Priante A. “Così l’Intelligenza artificiale è usata per imbrogliare negli studi clinici”. Corriere della Sera. 14 settembre 2026.
24. Taloni A, Scorcia V, Giannaccare G. “Large Language Model Advanced Data Analysis Abuse to Create a Fake Data Set in Medical Research”. JAMA Ophthalmol. 2023;141(12):1174–1175. doi:10.1001/jamaophthalmol.2023.5162.
25. Rumelhart DE, Hinton GE, Williams RJ. “Learning representations by back-propagating errors”. Nature. 1986;323:533–536. doi:10.1038/323533a0.